
AI agentide testimine on koht, kus enamik ettevõtteid komistab. Agent töötab demol laitmatult, aga päris klientide, päris andmete ja päris erandjuhtumite puhul hakkab vastuseid välja mõtlema. Vahe ei ole väike. Uuringud näitavad, et sama täpsuse saavutamise kulu erineb lahenduste vahel kuni viiskümmend korda ja et agendi järjepidevus langeb järsult, kui sama ülesannet korrata. Eesti ettevõtja jaoks tähendab see lihtsat asja. Kui sa ei mõõda agenti süstemaatiliselt, siis sa ei tea, kas ta töötab. Sa lihtsalt loodad.
See artikkel annab praktilise raamistiku. Mida täpselt mõõta, kui palju katsejooksusid teha, millal agent on tootmiskõlbulik ja millised vead korduvad kõige sagedamini. Numbrid tulevad värsketest uuringutest ja näited Eesti väikeettevõtte mõõtkavast.
Mis on AI agentide testimine
AI agentide testimine tähendab agendi kvaliteedi, usaldusväärsuse ja turvalisuse süstemaatilist mõõtmist kogu ülesande ulatuses. See hõlmab lõpptulemust, tööriistade kasutust, vahepealseid otsuseid ja reeglitest kinnipidamist. Tavaline tarkvaratest küsib, kas funktsioon tagastab õige väärtuse. Agendi testimine küsib midagi hoopis muud. Kas agent jõudis õige tulemuseni mõistlikul teel ja kas ta jõuab sinna ka järgmisel korral.
Just see teine osa teeb asja keeruliseks. Agent ei ole deterministlik. Sama sisend võib anda erineva väljundi. Seetõttu ei ütle üks õnnestunud katse midagi. Loeb see, mitu korda kümnest agent sama asja õigesti teeb.
Kui agentide tööpõhimõte on sinu jaoks veel uus, tasub alustada ülevaatest sellest, mida AI agendid äris teevad, ja alles seejärel tulla mõõtmise juurde.
Miks mõõtmine on Eesti ettevõttes eriti oluline
Suur korporatsioon saab endale lubada kümmet pilooti, millest üheksa kukub läbi. Eesti ettevõttes on tavaliselt üks katse ja üks eelarve. Vale agent tootmises ei maksa ainult raha. Ta sööb ära meeskonna usalduse kogu tehnoloogia vastu.
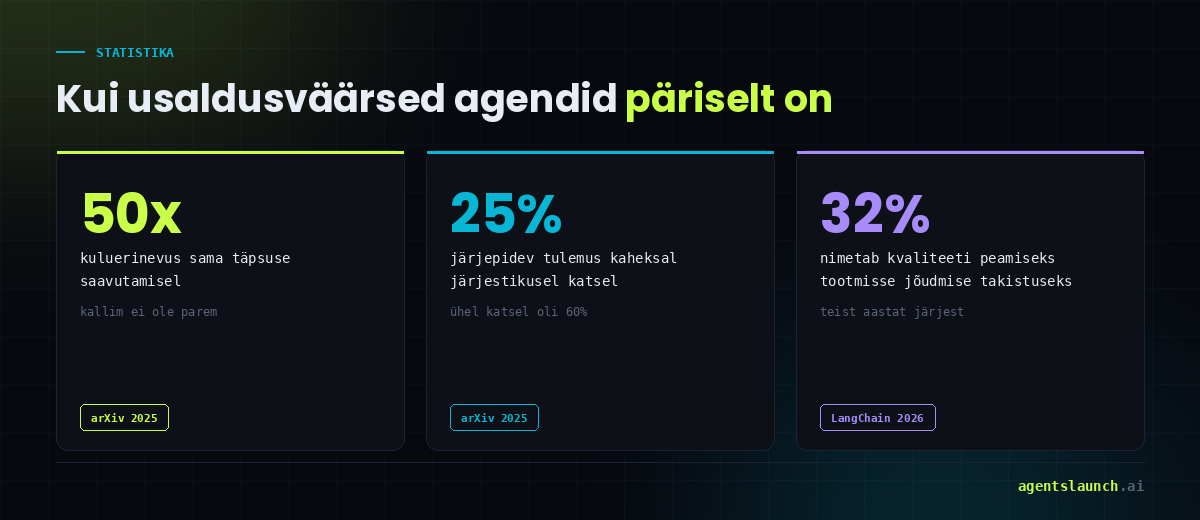
Numbrid toetavad seda ettevaatust. LangChaini 2026. aasta uuringu järgi, mis küsitles üle 1300 praktiku, on 57 protsendil organisatsioonidest agendid tootmises. 32 protsenti vastajatest nimetab peamiseks takistuseks kvaliteeti, mitte hinda ega tehnoloogiat. Teist aastat järjest. Samas uuringus ilmneb huvitav lõhe. Seiret on juurutanud ligi 89 protsenti vastajatest, aga süstemaatilisi testikomplekte ainult 52 protsenti. Ettevõtted vaatavad, mida agent teeb, aga ei mõõda, kas ta teeb seda õigesti.
Vahe on oluline. Seire ütleb sulle, et agent vastas kolmsada korda. Hindamine ütleb, mitu neist vastustest olid õiged.
Kolm arvu, mis muudavad pildi
Kõige selgema pildi annavad kolm uuringutulemust.
Kulu ei ole seotud kvaliteediga. Ettevõtte agentsüsteemide hindamise mitmemõõtmelist raamistikku käsitlev uuring (arXiv, 2025) leidis, et sama täpsuse saavutamise kulu erines lahenduste vahel kuni viiskümmend korda. Kallim lahendus ei olnud parem lahendus.
Korduvus. Sama uuring mõõtis midagi, mida enamik ettevõtteid ei mõõda üldse. Kui tulemust vaadati ühel jooksul, oli järjepidevus umbes 60 protsenti. Kaheksa järjestikuse jooksu korral langes see 25 protsendile. Ehk enamik sellest, mis ühel katsel näib töötavat, ei pea kordamisele vastu.
Võrdlustestid liiguvad kiiresti. Stanfordi HAI 2026. aasta AI Indexi järgi tõusis agentide edukus OSWorldi arvutiülesannete testil ligikaudu 12 protsendilt 66,3 protsendile. Tulemus on muljetavaldav. Samas jääb iga kolmas katse endiselt ebaõnnestunuks ja sama raport märgib, et AI agentide kasutuselevõtt ettevõtetes püsib enamikus ärifunktsioonides ühekohaliste protsentide juures.
Mida agendi juures üldse mõõta
Üks number ei kirjelda agenti. Praktikas tasub jälgida viit mõõdikut.
Ülesande lõpptulemus
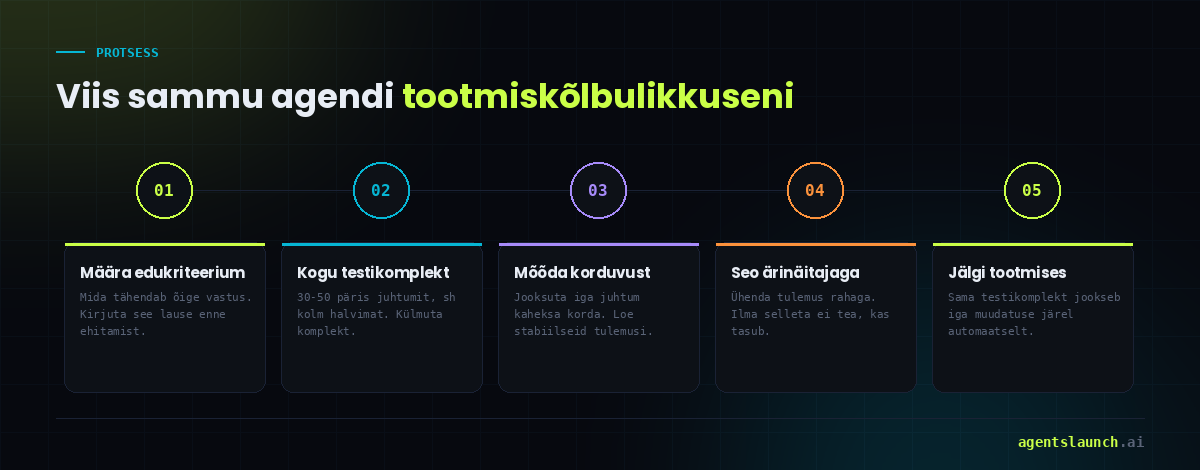
Kas agent lahendas ülesande nii, nagu inimene selle oleks lahendanud? See on kõige tähtsam mõõdik ja ka kõige raskem defineerida. Enne testimist tuleb kirja panna, mis on õige vastus. Kui seda lauset ei ole olemas, ei saa mõõta midagi.
Korduvus
Mitu korda kaheksast annab agent sama kvaliteediga tulemuse. Üks jooks on anekdoot. Kaheksa jooksu on andmepunkt. See on ainus mõõdik, mis ennustab, kuidas agent käitub esmaspäeva hommikul, kui keegi ei vaata.
Tööriistade kasutus
Kas agent kutsus õiget süsteemi õige parameetriga. Agent võib jõuda õige vastuseni valel teel. Kui ta pärib CRM-ist andmeid, mida ta ei peaks nägema, on tulemus küll õige, aga protsess on vigane. See on otseselt seotud teemaga, mida käsitlesime artiklis AI agentide ligipääsuõigustest.
Reeglitest kinnipidamine
Kas agent järgis ettevõtte poliitikat. Kas ta lubas kliendile allahindlust, mida ei tohi anda. Kas ta väljastas andmeid, mida ei tohi väljastada. Need vead ei ilmne täpsusmõõdikus, aga need lähevad kõige kallimaks.
Kulu ja latents
Õige vastus kolmekümne sekundiga ei ole klienditoes õige vastus. Ja viiskümmend korda kallim lahendus sama tulemuse eest ei ole parem lahendus. Mõõda mõlemat algusest peale.
Kuidas testimine praktikas käib
Kümne inimesega ettevõttes ei ole vaja eraldi kvaliteediosakonda. Vaja on korrektset harjumust.
Kogu kokku päris juhtumid. Võta kolmkümmend kuni viiskümmend tegelikku päringut oma viimase kuu suhtlusest. Mitte väljamõeldud näiteid. Päris kliendikirju koos kõigi kirjavigade, poolikute lausete ja ebaselge sõnastusega. Lisa kindlasti kolm kõige ebamugavamat juhtumit, mida sa kardad.
Kirjuta õige vastus välja. Iga juhtumi juurde käib inimese kirjutatud etalonvastus või vähemalt loend tingimustest, mille vastus peab täitma. See töö võtab ühe päeva ja säästab kuu.
Jooksuta mitu korda. Jooksuta iga juhtum kaheksa korda läbi. Loe kokku, mitu korda tulemus vastas kriteeriumile. See arv on sinu tegelik usaldusväärsus.
Lase tulemused inimesel üle vaadata. Automaatne hindaja on kiire, aga ta jätab märkamata tooni, konteksti ja poliitikarikkumised. Kõige usaldusväärsema pildi annab automaatsete mõõdikute ja inimhinnangu kombinatsioon. Piisab sellest, kui üks inimene vaatab kord nädalas kakskümmend juhuslikku vestlust.
Külmuta testikomplekt. Kui testikomplekt muutub iga kord, kui sa agenti parandad, mõõdad sa iseennast, mitte agenti. Jäta komplekt paika ja lisa sinna ainult uusi päris juhtumeid.
Millal on agent tootmiskõlbulik
Universaalset läve ei ole. Lävi sõltub sellest, mis juhtub siis, kui agent eksib.
- Madal risk. Sisemine kokkuvõtete tegija või mustandite kirjutaja. Siin piisab, kui agent on inimesest kiirem ja enamasti kasulik. Inimene vaatab niikuinii üle.
- Keskmine risk. Klienditoe esimene vastus või müügivihje kvalifitseerimine. Siin peaks agent lahendama vähemalt neli juhtumit viiest ja andma ülejäänud selgelt inimesele üle. Loe lähemalt artiklist AI klienditoe agendi kohta.
- Kõrge risk. Raha liigutamine, lepingud, õiguslikud vastused. Siin ei tohi agent tegutseda ilma inimese kinnituseta, olenemata sellest, kui hea on testitulemus.
Kõige olulisem reegel on järgmine – enne testimist pane kirja lävi, mille juures sa agendi käivitad. Kui lävi otsustatakse pärast tulemuste nägemist, siis see ei ole lävi, vaid õigustus.
Levinumad vead ja kuidas neid vältida
Demo peetakse tõestuseks. Kõige sagedasem viga. Kolm õnnestunud vestlust juhatuse ees ei tõesta agendi töökindlust. Küsi alati, mitu korda kaheksast see töötas.
Testitakse ainult ilusaid juhtumeid. Meeskond koostab testid nendest päringutest, mille peale agent kindlasti vastab. Reaalsus saadab hoopis poolikuid lauseid, valesid tootenimesid ja vihaseid kliente. Ehita testikomplekt just nende ümber.
Seiret aetakse segi hindamisega. Töölaud, mis näitab vastuste arvu ja vastamisaega, ei ütle midagi kvaliteedi kohta. Vaja on mõlemat.
Võrdlustesti tulemus võetakse lubaduseks. Tarnija ütleb, et mudel saavutab 90 protsenti. Sinu andmetel, sinu terminoloogiaga ja sinu klientidega on tulemus teine. Testi oma juhtumitega.
Testitakse üks kord. Mudel uueneb, promptid muutuvad, andmed vananevad. Agent, kes oli juunis korralik, võib septembris olla nõrgem. Jooksuta sama komplekti iga muudatuse järel. See on sama põhimõte, mis viis 88 protsenti projektidest ebaõnnestumiseni artiklis AI agentide tootmisse viimisest.
Tulemust ei seota rahaga. Kui sa ei tea, mitu eurot üks lahendatud juhtum säästab, ei oska sa öelda, kas 70 protsenti on hea või halb. Seo mõõdik ärinäitajaga kohe alguses.
Kuidas alustada juba sel nädalal
Kolm sammu, mis ei nõua uut tarkvara.
Esmaspäev. Vali üks protsess, kus AI agent juba töötab või kohe tööle hakkab. Kirjuta ühe lausega, mida tähendab selle protsessi juures õige tulemus.
Teisipäev. Korja kokku kolmkümmend päris juhtumit viimase kuu kirjavahetusest. Salvesta need tabelisse koos oodatud vastusega.
Kolmapäev. Jooksuta agent kõigi juhtumite peal kaheksa korda. Loe kokku, mitu korda tulemus oli õige. See arv ongi sinu lähtepunkt.
Pärast seda on sul olemas number, mida saab parandada. Ilma selleta on igasugune parandus arvamus. Praktilisi näiteid selle kohta, kuidas agendid päris protsessides töötavad, leiad AI voogude lehelt.
KKK – korduma kippuvad küsimused
Kui palju testijuhtumeid on vaja AI agendi hindamiseks?
Väikeettevõttes piisab alustuseks kolmekümnest kuni viiekümnest päris juhtumist. Oluline ei ole maht, vaid see, et komplekt sisaldaks ka raskeid ja ebamugavaid juhtumeid. Sada ilusat näidet annab halvema pildi kui kolmkümmend päris juhtumit.
Mitu korda tuleks agenti sama ülesandega testida?
Vähemalt kaheksa korda. Uuringud näitavad, et üksikul jooksul mõõdetud järjepidevus langeb kaheksa jooksu korral 60 protsendilt 25 protsendile. Üks õnnestunud katse ei tõesta midagi.
Mis vahe on seirel ja hindamisel?
Seire näitab, mida agent tegi ja kui kiiresti. Hindamine näitab, kas ta tegi seda õigesti. Enamik ettevõtteid on juurutanud seire, aga jätnud hindamise tegemata. See on kõige levinum lünk.
Kas piisab automaatsetest mõõdikutest?
Ei piisa. Automaatne hindamine on kiire ja odav, aga ta jätab märkamata tooni, konteksti ja ettevõtte reeglite rikkumised. Kõige usaldusväärsema tulemuse annab automaatika koos regulaarse inimülevaatusega.
Millise täpsuse juures võib agendi tootmisse lasta?
See sõltub riskist. Sisemise abivahendi puhul piisab madalamast lävest. Klienditoes peaks agent lahendama vähemalt neli juhtumit viiest ja andma ülejäänud inimesele üle. Raha või lepingutega seotud tegevustes on inimese kinnitus alati vajalik.
Kui tihti tuleb testid uuesti läbi jooksutada?
Iga kord, kui muutub mudel, prompt, andmeallikas või protsess. Lisaks tasub sama komplekti jooksutada kord kuus ka siis, kui midagi ei ole muutunud, sest mudelid uuenevad tarnija poolel.
Kes peaks ettevõttes agentide testimise eest vastutama?
Inimene, kes tunneb protsessi, mitte tingimata tehniline inimene. Müügiagendi kvaliteeti oskab hinnata müügijuht. Tehniline pool on lihtsam. Raskem on defineerida, mis on õige vastus.
Kokkuvõte
AI agentide testimine ei ole tehniline lisategevus, vaid ainus viis teada saada, kas agent päriselt töötab. Kolm arvu tasub meeles pidada. Sama täpsuse hind erineb lahenduste vahel kuni viiskümmend korda. Järjepidevus langeb kaheksa jooksu korral 60 protsendilt 25 protsendile. Kvaliteeti nimetab peamiseks takistuseks 32 protsenti praktikutest.
Hea uudis on see, et algus on odav. Kolmkümmend päris juhtumit, kaheksa jooksu ja üks selge edukriteerium annavad sulle numbri, mida saab parandada. Kõik ülejäänu on selle numbri liigutamine.
Kui soovid, et agendi mõõtmine, testikomplekt ja lävendid oleksid paigas juba enne käivitamist, siis vaatame need koos üle.
BRONEERI TASUTA KONSULTATSIOON
Vaata ka AgentsLaunchi pakette, kui soovid teada, kuidas agendi juurutamine ja mõõtmine ühes paketis kokku käivad.